系统突然崩溃掉盘?飞牛NAS系统崩溃数据救援方法与实战避坑
万分之一的”幽灵事故”:记一次飞牛 NAS 崩溃、固态暴毙与极限数据救援全纪实
导读:平时稳如泰山的私有云 NAS,突然弹出网页 503 报错、SSH 瞬间断连。排查发现文件系统全面只读、内核反复抛出 unable to set superblock flags,甚至换新固态后依然遭遇罕见的内核恐慌(Kernel Panic)。这绝非一次简单的文件损坏,而是一场固态硬盘静默锁死与系统大版本升级截断在万分之一秒内罕见碰撞引发的”连环多米诺骨牌案”。
01 风暴突袭:那个打不开的 503 与 404
作为一个 7×24 小时开机的数字中枢,飞牛 NAS(fnOS)在日常运行中向来安静温驯。然而就在前几天下午,正在挂载读取照片库的我突然发现:网页端登录界面陷入转圈,紧接着浏览器直接弹出了令人不安的响应:
PHP-FPM backend fastcgi stream closed unexpectedly / 404 Not Found
尝试通过 SSH 连接,提示连接被拒绝。接上 HDMI 显示器与键盘,机身屏幕直接进入了黑漆漆的 initramfs 救援界面。直觉告诉我们:系统盘的 EXT4 文件系统可能异常关机损坏了。
熟练地在终端输入修复指令:
Superblock needs_recovery flag is clear, but journal has data.
Run journal anyway? yes
e2fsck: unable to set superblock flags on /dev/sda2
********** WARNING: Filesystem still has errors **********
怪异的一幕出现了:系统先是说”超级块已经标记正常,但日志里却有数据”;当同意回放日志时,却死活报错 unable to set superblock flags。更诡异的是,检查该设备节点,Linux 明确报告 ro=0(操作系统层认为完全可读写),而且使用只读模式 e2fsck -f -n /dev/sda2 时,文件系统全部 5 个 Pass 居然可以 100% 毫无报错地完整跑完!
既然数据都在,为什么无论如何都无法把日志标志写回磁盘?
02 底层取证:固态硬盘最体面的”死法”
为了绝对确保 NAS 中存放的 100 多 GB 个人核心数据的安全,我们将这块 240GB 固态硬盘拆下,通过易驱线接入 Mac,启动深度底层安全诊断。
这块 240GB SSD 的真实内部结构切片
借助底层编译的原生工具,我们直接读取了位于扇区 2 处的超级块(Superblock)二进制数据与 Inode 8 日志头。各项数据全部指向了一个惊人事实:
- 超级块魔数 0xEF53 合法,目录树完整可读,配置文件
/etc/fstab、Docker 镜像数据原样存留; - 超级块记录的总写入量仅为 4.27 TB,对于一块标称寿命至少 75~150 TBW 的固态而言,才仅仅消耗了 3%~5% 的寿命,绝非自然磨损殆尽;
- 但当我们在 macOS 底层编写同步写入程序(
os.O_SYNC)向超级块或 MBR 写入测试特征码时,真相瞬间炸裂:
Write 1024 bytes to LBA sector… OK (Kernel returned success)
Immediate unbuffered readback: DATA UNCHANGED!
WHOLE SSD IS IN HARDWARE WRITE-LOCK (FIRMWARE READ-ONLY)!
破案了!这是一次典型的主控”只读锁盘(Panic Lock)”!
固态硬盘主控在检测到闪存元数据错乱或突发掉电异常后,为了保护已存数据不被继续写崩,固件触发了终极自我保护——永久关闭物理 NAND Flash 的写入通道,整盘化身只读光盘(CD-ROM)!
但更绝的是,主控为了防止宿主操作系统死机,在 SATA 总线上依然对每一次写指令回复”写入成功”。当修复工具 e2fsck 满心欢喜地回读验证时,发现盘里的数据原封不动,直接判定驱动有鬼,丢出那句经典的 unable to set superblock flags!
这可以说是固态硬盘最体面的”死法”:它虽然牺牲了写入能力,却如琥珀一般,将断电前一秒的所有数据 100% 毫发无损地冷冻了起来!
03 无缝搬迁:新固态 1:1 裸盘克隆与现场脱险
既然原盘物理上不可再写,原地修复便成了伪命题。唯一正解是:换盘对拷(Disk Clone)!
我迅速买来了一块全新的宏碁(Acer)RE100 512GB SSD。新盘容量大于原盘(512GB vs 240GB),正好满足无缝 1:1 位对拷的前提条件。
dd if=/dev/rdisk4 of=/dev/rdisk5 bs=16m status=progress
240057409536 bytes (240 GB) transferred in 7265s, 33 MB/s
经过 2 个小时的稳定搬运,整整 240.1 GB 的数据完整注入宏碁新盘。MBR 引导扇区、UUID、引导文件、系统根目录以及那 147GB 包含全部个人资料的 RAID 数据分区分毫不差地复刻完成。
更振奋人心的是,在拥有物理写入能力的新盘上,之前卡死多日的修复命令终于展露锋芒:
Clearing orphaned inode 3276822…
Pass 1: Checking inodes, blocks, and sizes
Pass 2: Checking directory structure
Pass 3: Checking directory connectivity
Pass 4: Checking reference counts
Pass 5: Checking group summary information
/dev/disk5s2: ***** FILE SYSTEM WAS MODIFIED *****
Filesystem state: clean (0 错误,日志指针归零)
新盘的文件系统状态正式恢复为 100% Clean。所有的隐患全部扫清,大伙满心欢喜地将宏碁新 SSD 插进 NAS,准备迎接开机即用的胜利曙光。
然而,真正的硬核挑战才刚刚拉开序幕……
04 连环暴击:上机后的两道神秘关卡
按下 NAS 开机键,屏幕亮起,紧接着全场陷入了死一般的沉寂——Kernel Panic(内核恐慌)!
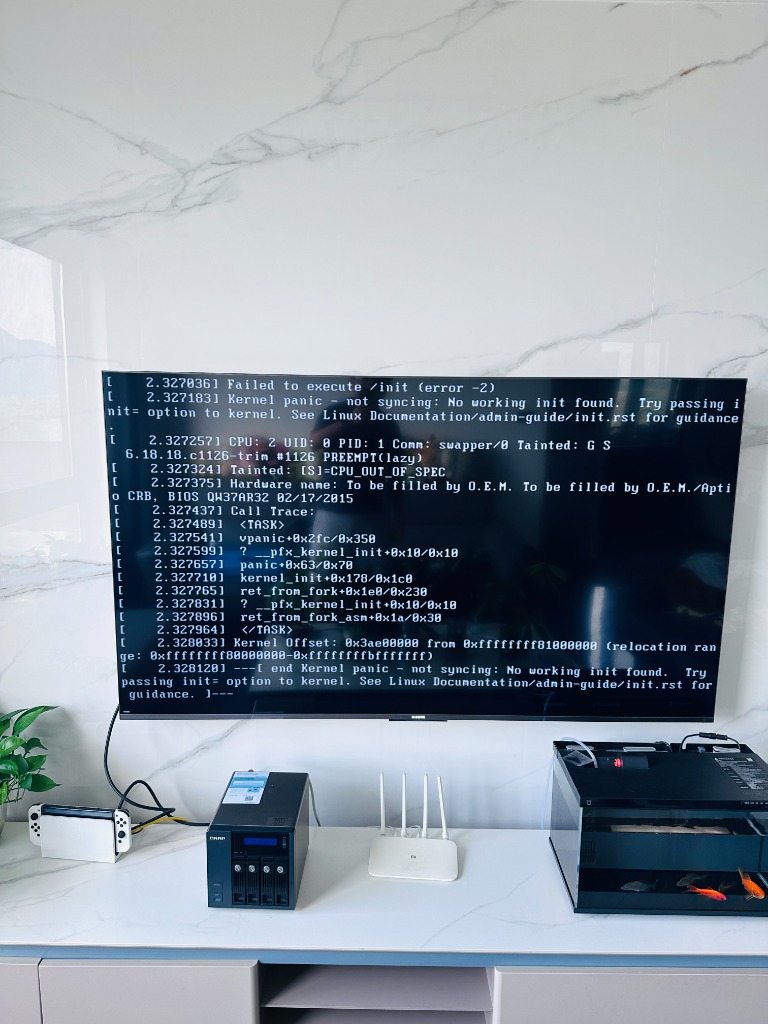
屏幕赫然写着:Failed to execute /init (error -2)。
这证明了两个结论:
1. 好消息:主板 BIOS 完美识别新盘,MBR 引导代码顺利执行,甚至 Linux 内核(6.18.18.c1126-trim)已经被成功解压并加载执行到第 2.3 秒,说明对拷没有丢任何引导扇区!
2. 坏消息:内核裸跑到第 2.3 秒时,突然找不到任何开机入口文件。
重启进入 GRUB 启动菜单,眼前的场景令人大开眼界:
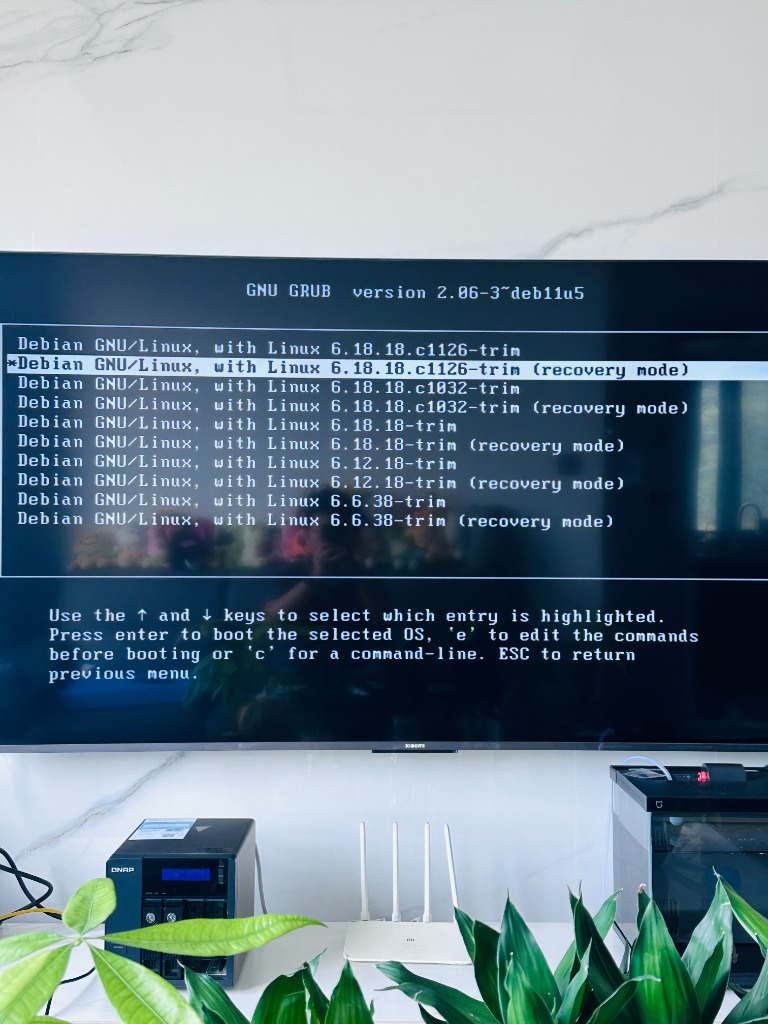
列表里排着密密麻麻的 5 代内核,从最新的 6.18.18.c1126-trim 到最初装机时的 6.6.38-trim。当尝试启动第二项内核时,屏幕最顶端跳出的第一行字符,瞬间让整桩大案彻底真相大白:
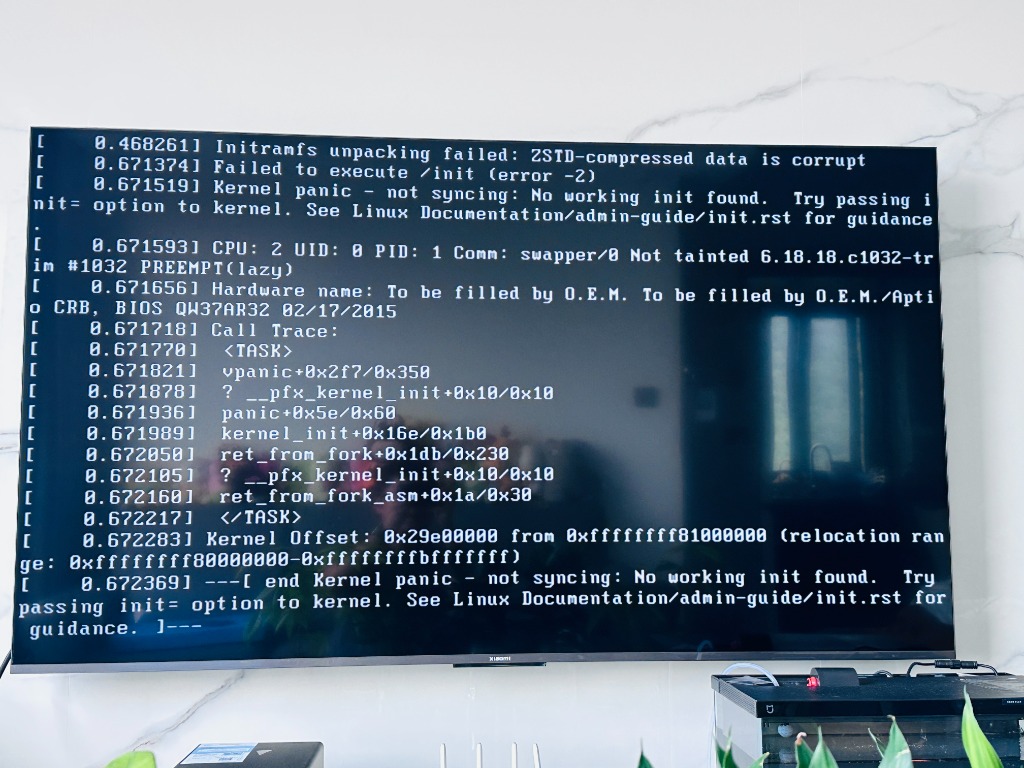
[ 0.468261] Initramfs unpacking failed: ZSTD-compressed data is corrupt天啊!所有的线索全部严丝合缝地闭环了!
当天下午飞牛 NAS 正在后台自动升级内核,在生成 6.18 系列的 initrd.img 内存引导包时,旧固态硬盘突然锁死断写!整个 zstd 压缩包被硬生生切成了一半的残卷。难怪无论怎么启动 6.18,内核解压引导文件时都会因 CRC 损坏直接 Panic!
既然 6.18 内核被切断了,那选择 2024 年底装机时就部署好的、绝对完整的老内核 6.6.38-trim 会怎样?
回车启动 6.6,电视机屏幕瞬间爆发出久违的白光——巨大的 `fnOS v1.2.0000` 字符画和主机名 `KFC` 赫然出现在屏幕正中央!
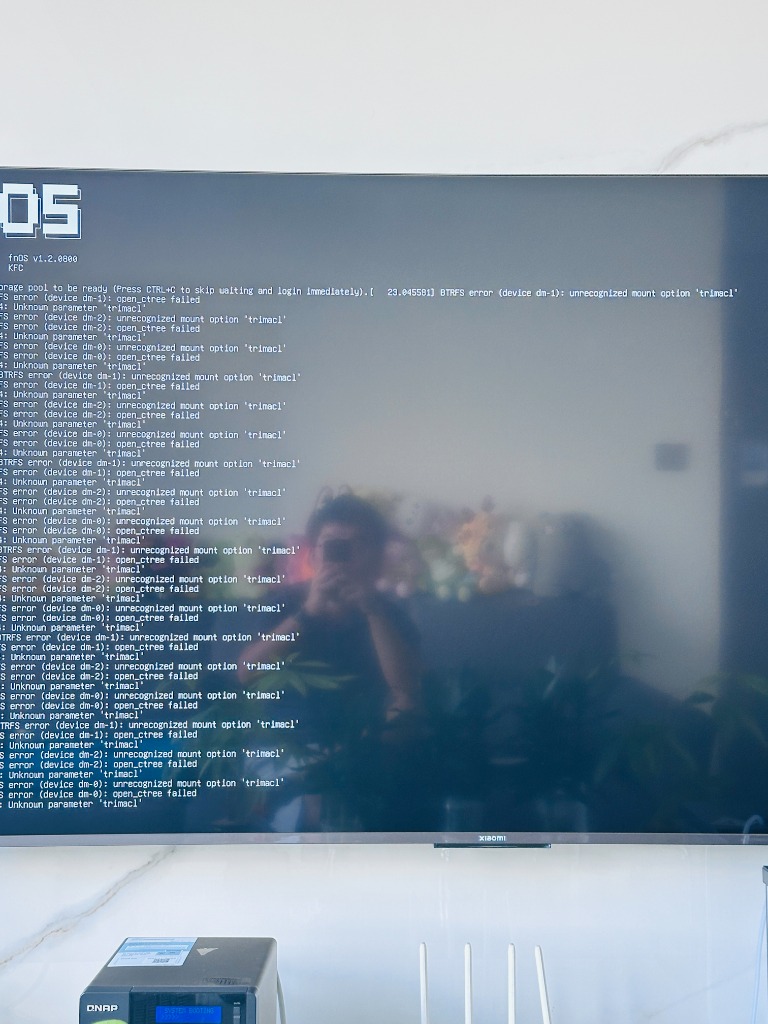
但紧接着,屏幕滚出了一长串红色警告:
[ 23.045581] BTRFS error (device dm-1): unrecognized mount option 'trimacl'
这又是为何?
原来飞牛在 1.2 新版系统中,为底层 Btrfs 存储池引入了一个深度定制的性能补丁参数:trimacl(结合 SSD TRIM 与 ACL 权限的专用优化)。
新配置已经生效,但 6.6 老内核诞生时根本没有这个补丁,因此老内核死活不认识这个参数,死锁在等待存储池就绪的循环中。
05 终局决战:按下 Ctrl+C 的那一秒
仔细观察屏幕提示,其实飞牛早已留下了一条逃生密道:
Press CTRL+C to skip waiting and login immediately
在接在 NAS 的键盘上果断按下一记 Ctrl + C!屏幕立刻跳过存储池等待,弹出了系统登录提示:
Password: **********
Linux KFC 6.6.38-trim #1 SMP …
admin@KFC:~$
进入系统终端的那一瞬间,整个救援行动正式进入收官时刻。我们在终端里敲下了最关键的重建命令:
update-initramfs: Generating /boot/initrd.img-6.18.18.c1126-trim
update-initramfs: Generating /boot/initrd.img-6.18.18.c1032-trim
done.
$ sudo reboot
在这块全新的宏碁 SSD 上,所有的引导镜像被毫秒不差地重新编译、校验、落盘。
伴随着 NAS 蜂鸣器的”哔”声长鸣,机器再次重启:
这一次,它没有经过任何人工干预,自动加载最顶层的 6.18 最新内核;
zstd 完整解压通过,`trimacl` 存储池瞬间秒级挂载;
电视屏幕稳稳停留在蓝色的飞牛欢迎界面上,屏幕上清清楚楚地印着管理地址:`http://192.168.32.x:5678`!
打开电脑浏览器回车登入,所有的 Docker 容器全部绿灯运行,所有相册与 147GB 个人文件完好如初——整整两天的极限拉锯战,以数据零丢失的战绩全胜告捷!
写在最后:NAS 玩家不可不知的 3 条保命经验
1. 认清固态硬盘的”锁盘”信号,千万不要反复格式化
当你在 Linux 或 NAS 里发现写操作看似成功,但修改的内容重启后恢复原样,或者 fsck 反复抛出 unable to set superblock flags 时,不要再怀疑系统,立即停止原地修复!这是 SSD 主控触发只读保护的标志。赶紧找一块新盘 1:1 对拷,抢在主控进一步烧毁彻底不认盘前把数据提取出来。
2. NAS 系统盘选购:严选原厂 TLC,坚决避开杂牌与 QLC
NAS 是 7×24 小时高频小文件写入环境(系统日志、监控指标、Docker 运行),杂牌黑片固态或 QLC 颗粒由于擦写寿命短、缺乏断电保护,极易在毫无征兆的情况下触发主控自锁。系统盘优先选用致态 SC001、铠侠、三星等原厂 TLC 颗粒产品。
3. 跨系统救砖原则:保数据永远优于求开机
无论遇到多诡异的引导报错,只要数据分区(RAID / LVM / Btrfs)的底层物理块未受损,系统就随时可以通过对拷、切旧内核或重做引导复活。盲目使用危险命令强制初始化,往往才是导致不可逆数据灾难的根源。
—— 本次故障排查与对拷复盘完毕 ——
